Хранилище данных по medallion-архитектуре
Пять публичных источников, ни один из которых не согласуется с другими, загружены в Microsoft Fabric и очищены через bronze, silver и gold до звёздной схемы, к которой Power BI обращается без подзапросов.
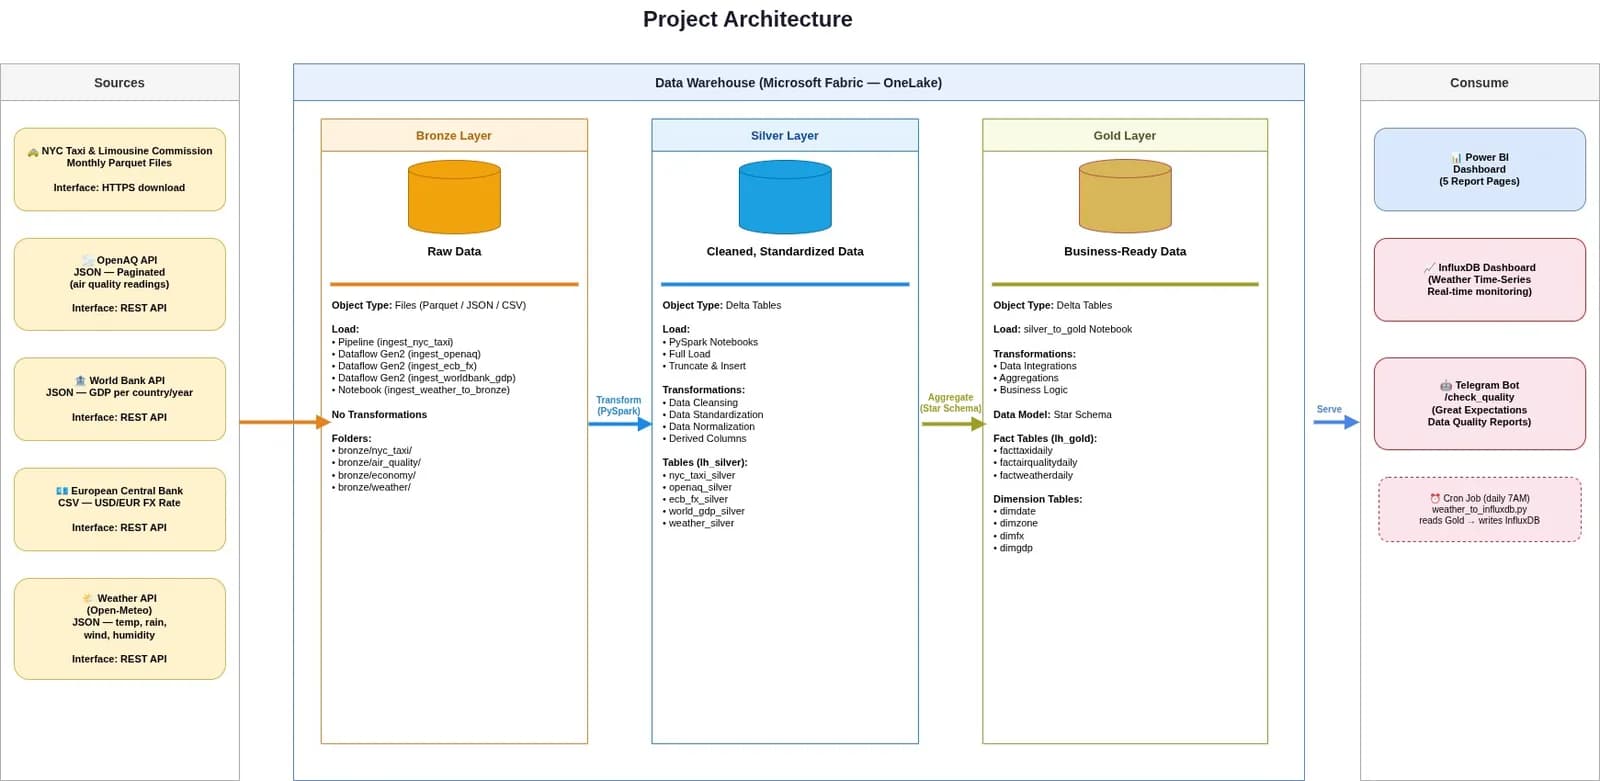
Пять источников, которые ни в чём не сходятся
Хранилище тянет данные из пяти реальных публичных источников, специально выбранных так, чтобы они не совпадали:
- NYC Taxi and Limousine Commission — месячные файлы Parquet по HTTPS
- OpenAQ — постраничный JSON с замерами качества воздуха
- World Bank — JSON с ВВП по странам и годам
- European Central Bank — CSV с курсом USD к EUR
- Open-Meteo — JSON с температурой, осадками, ветром и влажностью
Разные форматы, разная гранулярность, разные представления о том, что такое дата. Данные такси приходят по поездкам, качество воздуха — по замерам, ВВП — раз в год. Свести их в одну модель и есть вся задача.
Bronze молчит
Слой bronze хранит файлы ровно такими, какими они пришли: Parquet, JSON и CSV — в bronze/nyc_taxi/, bronze/air_quality/, bronze/economy/ и bronze/weather/. Никаких преобразований вообще.
Эта сдержанность и есть смысл слоя. Когда через три недели число выглядит неправильно, bronze — единственное место, которое может ответить, прислал его таким источник или его таким сделало преобразование. Слой, который «слегка причёсывает» данные на входе, уничтожает улики.
Приём данных сделан по-разному намеренно, под каждый источник, а не через один механизм: Pipeline для файлов такси, Dataflow Gen2 для OpenAQ, курса ЕЦБ и ВВП Всемирного банка, и Notebook для погоды.
Silver спорит
Silver — это таблицы Delta, которые загружают ноутбуки PySpark полной загрузкой с truncate и insert. Здесь происходят очистка, стандартизация, нормализация и расчёт производных колонок; на выходе — nyc_taxi_silver, openaq_silver, ecb_fx_silver, world_gdp_silver и weather_silver.
Полная загрузка вместо инкрементальной была верным решением на этом объёме. Инкрементальная загрузка покупает скорость ценой ошибок корректности, а объём здесь в скорости не нуждался.
Gold смоделирован под чтение
!Звёздная схема: три ежедневные таблицы фактов в окружении измерений даты, зоны, курса и ВВП
Три таблицы фактов, все с дневной гранулярностью: facttaxidaily, factairqualitydaily и factweatherdaily. Вокруг них четыре измерения: dimdate, dimzone, dimfx и dimgdp.
Два решения в модели, которые стоит назвать:
- Всё приведено к дневной гранулярности. Поездки такси и замеры воздуха приходят гораздо мельче. Именно предварительная агрегация позволяет одному измерению даты обслуживать все три факта — а без этого вопрос, охватывающий несколько источников, вообще не имеет ответа.
- У `dimgdp` нет внешнего ключа. ВВП годовой и на уровне страны, поэтому честно соединить его с дневным фактом нельзя. Он присоединяется по году как экономический контекст, и на схеме это сказано прямо. Выдумать суррогатный ключ ради более аккуратной картинки значило бы заявить связь, которой в данных нет.
dimdate несёт year, month, day, month_name, day_name, day_of_week, quarter и is_weekend, чтобы отчёт фильтровал по колонке, а не разбирал строку во время запроса.
Три выхода
Слой gold питает трёх потребителей — это неплохая проверка того, насколько хорошо он смоделирован:
- Power BI — пять страниц отчёта, построенных прямо на gold.
- InfluxDB — для временных рядов погоды. Cron в 07:00 запускает
weather_to_influxdb.py, который читает gold и пишет в InfluxDB для мониторинга в реальном времени. Python-клиент для него написал я. - Telegram-бот с командой
/check_quality, который по запросу отдаёт отчёты Great Expectations о качестве данных.
Последний важнее, чем кажется. Отчёты о качестве данных, живущие в ноутбуке, читают один раз. Отчёт, который можно запросить с телефона, читают тогда, когда что-то выглядит странно — а это единственный момент, когда он и нужен.